Введение
При адаптивном обучении прогноз правильного ответа используется для выбора следующего задания и оценки необходимости дополнительной практики. Такой прогноз должен учитывать историю ответов и особенности текущего задания. В классической модели BKT история сводится к вероятности владения навыком, а вероятность наблюдаемого ответа определяется постоянными параметрами угадывания и случайной ошибки [4]. Это позволяет проследить вычисление прогноза, но ограничивает описание контекстных различий между заданиями.
Нейросеть способна моделировать нелинейную зависимость ответа от признаков задания и истории. Однако произвольная нейросетевая надстройка может существенно изменить базовый прогноз. Если система использует BKT как опорную модель, возникает самостоятельная математическая задача: разрешить контекстную коррекцию, одновременно ограничив её амплитуду и сохранив порядок базовых вероятностей при фиксированном контексте. Цель исследования — построить такое преобразование и оценить возникающий компромисс на контролируемых данных.
Вклад работы состоит в задании конкретного весового механизма коррекции, выводе точного порога его универсальной монотонности и получении детерминированных оценок изменения вероятности и потери. Вычислительная часть проверяет модель, её упрощения и контрольный режим без контекстного эффекта. Предлагаемый вклад относится к конструкции и анализу выходного преобразования; сама идея сочетания нейросетей с BKT не является новой.
Связанные исследования
Baker, Corbett и Aleven исследовали контекстную оценку вероятностей угадывания и случайной ошибки, включая проблему вырожденных параметров BKT [2, с. 406–415]. Yudelson, Koedinger и Gordon показали значимость индивидуализации параметров для разных обучающихся [8, с. 171–180]. Эти работы обосновывают необходимость учитывать неоднородность учебных взаимодействий, но не делают произвольную контекстную поправку автоматически интерпретируемой.
В Deep Knowledge Tracing последовательность ответов обрабатывается рекуррентной нейросетью [7, с. 505–513]. В более поздней работе Badrinath и Pardos нейросеть генерирует параметры BKT; предложены подходы OptimNN и BKTransformer [1]. Следовательно, общий тезис о первом нейросетевом расширении BKT был бы некорректен. В настоящей работе параметры фильтра после его обучения фиксируются, а MLP изменяет только вероятность наблюдаемого ответа. Ограничение относится к выходному прогнозу, а не к параметрам переходов скрытого состояния.
Калибровка вероятностей представляет отдельную задачу: улучшение функции потерь не доказывает согласованность численных вероятностей с частотами событий. Исследование Guo и соавторов демонстрирует необходимость специального анализа калибровки нейросетей [5, с. 1321–1330]. Поэтому далее наряду с логарифмической потерей и оценкой Брайера рассматривается ECE, а гарантии монотонности не отождествляются с гарантией калибровки.
Вероятностная постановка
Рассматривается один навык. Для каждого обучающегося задана последовательность бинарных ответов yₜ ∈ {0, 1}. Скрытая переменная Kₜ указывает на владение навыком перед ответом t. История Hₜ₋₁ содержит только предыдущие ответы. Обозначим через lₜ = P(Kₜ = 1 | Hₜ₋₁) оценку BKT, через g — вероятность правильного ответа без владения навыком, через s — вероятность ошибки при владении навыком, через T — вероятность освоения навыка после очередной попытки. Предполагаются 0 < g, s < 1 и g + s < 1; забывание в базовой модели отсутствует.
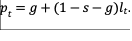
Начальное значение l₁ = L₀. После наблюдения yₜ выполняются байесовское обновление и переход обучения:

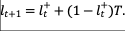
Формулы (1)–(3) задают стандартный фильтр BKT. Вероятность владения навыком lₜ и вероятность правильного ответа pₜ имеют разный смысл. Далее корректируется pₜ. Скорректированное значение не подставляется в формулу (2): при такой подстановке потребовалась бы согласованная новая модель эмиссии. В контекстном режиме BKT остаётся приближённым фильтром, поэтому его скрытые оценки не объявляются точными апостериорными вероятностями реального процесса.
Архитектура ограниченной коррекции
Пусть zₜ ∈ ℝᵈ — признаки, доступные до текущего ответа. Однослойный по скрытому представлению MLP с h нейронами вычисляет скалярную функцию:
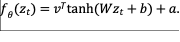
Здесь W ∈ ℝʰˣᵈ, b и v ∈ ℝʰ, a ∈ ℝ — обучаемые параметры, а tanh применяется покомпонентно. Обозначим сигмоиду σ(x) = 1/(1 + exp(−x)), logit(p) = ln(p/(1 − p)). Введём ограниченную поправку и вес:
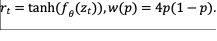
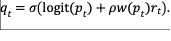
Параметр ρ ≥ 0 задаёт разрешённую амплитуду. При ρ = 0 модель совпадает с BKT. Значение w(p) достигает единицы при p = 1/2 и стремится к нулю на краях интервала. Это проектный выбор, означающий более слабое вмешательство при крайних базовых прогнозах. Он не измеряет эпистемическую неопределённость BKT: уверенный базовый прогноз также может быть ошибочным, и тогда ослабление поправки способно ухудшить качество.
В рассматриваемой архитектуре pₜ не подаётся на вход fθ. Это условие необходимо для последующего доказательства монотонности при фиксированном zₜ. Признаки истории могут коррелировать с pₜ, однако при изменении всей истории вместе с zₜ теорема не утверждает сохранение порядка прогнозов. Геометрия преобразования для предельных значений r показана на рисунке 1; r = ±1 соответствует замыканию множества выходов tanh.
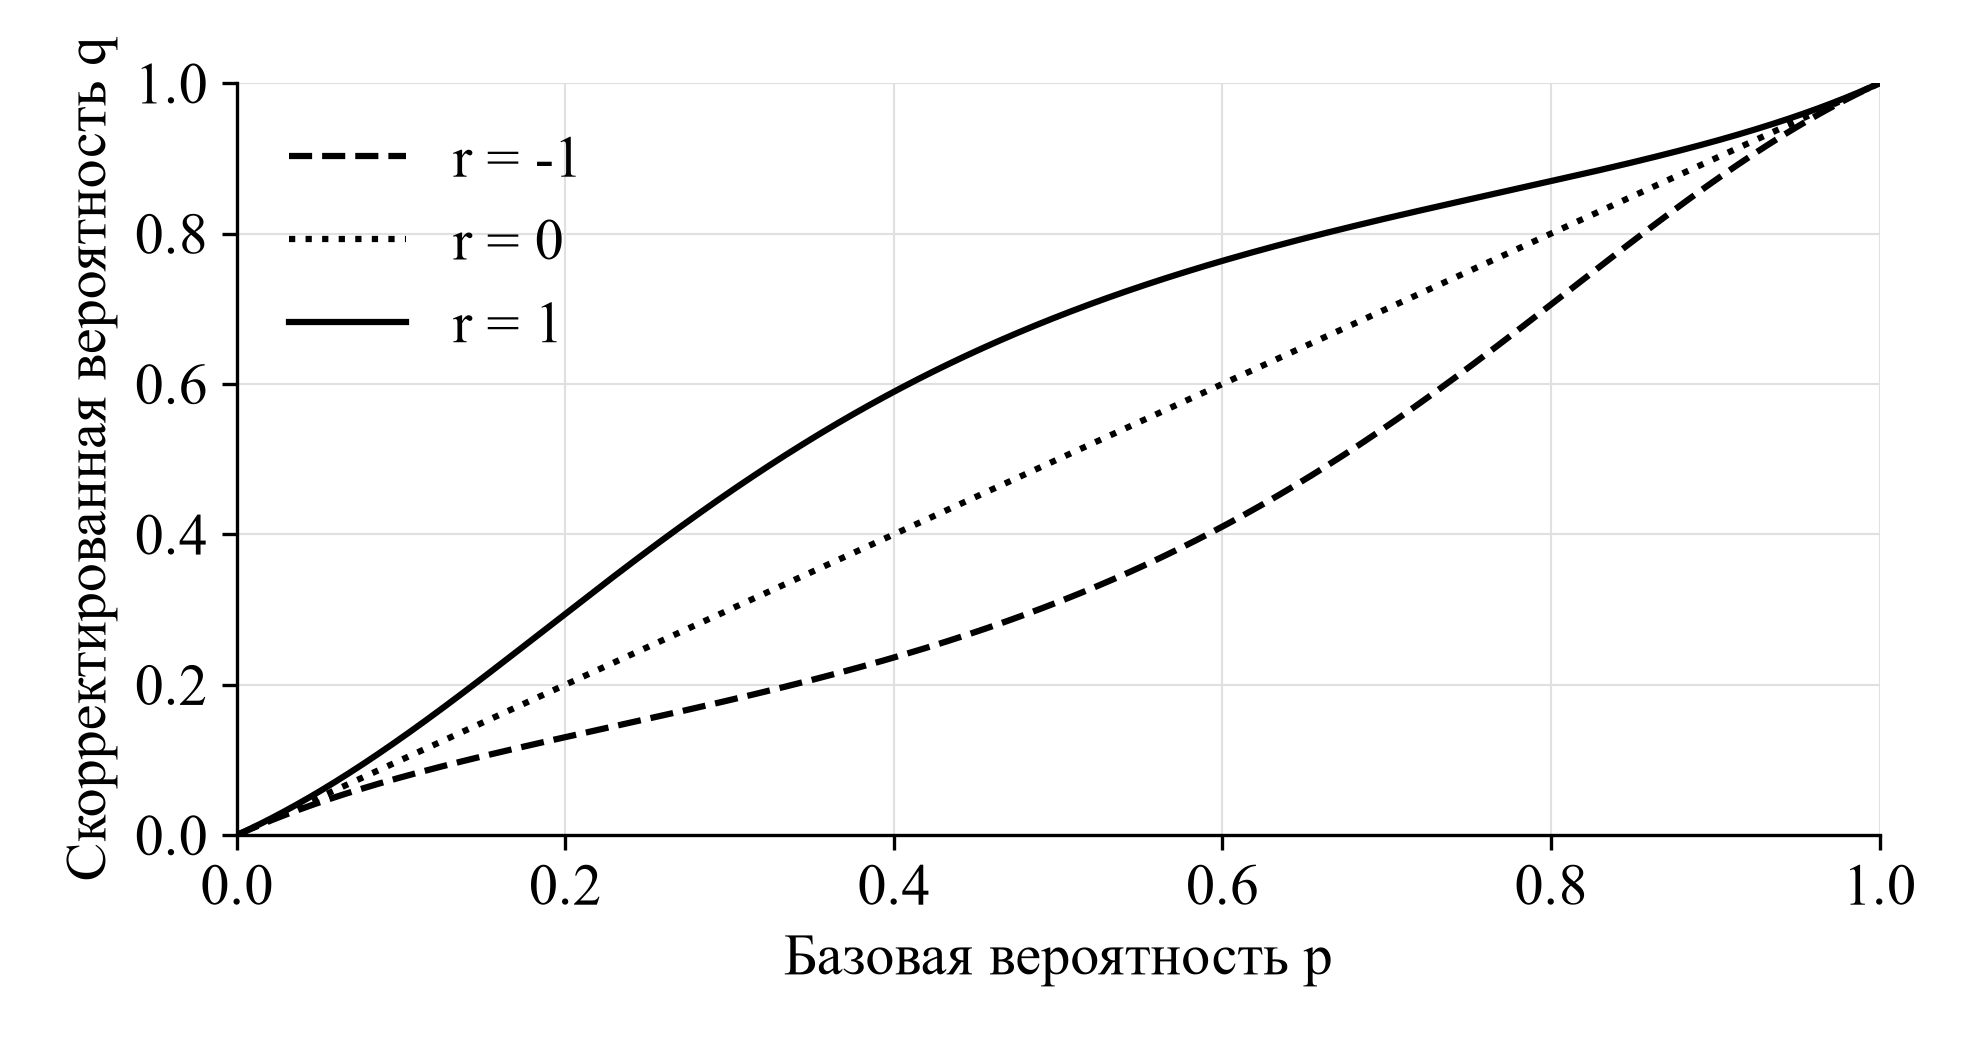
Рисунок 1. Семейство монотонных преобразований при ρ = 0,8
Математические свойства
Утверждение 1. При фиксированном z преобразование (6) строго возрастает по p ∈ (0, 1) для 0 ≤ ρ < 3√3/2. Число 3√3/2 является точным верхним порогом для универсальной неотрицательности производной по всем p и r ∈ [−1, 1].
Доказательство. Положим η(p) = logit(p) + 4ρp(1 − p)r. Поскольку σ′(η) > 0, знак производной q определяется производной η:
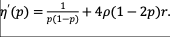
После умножения на положительное p(1 − p) получаем нижнюю оценку 1 − 4ρp(1 − p)|1 − 2p|. Подстановка x = |1 − 2p| сводит максимизацию к функции x(1 − x²)/4 на [0, 1]. Её максимум достигается при x = 1/√3. Следовательно,
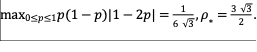
При ρ < ρ* нижняя оценка положительна. При ρ = ρ* производная неотрицательна; при любом конечном fθ, то есть |r| < 1, она остаётся положительной. Если ρ > ρ*, выбираем p = (1 − 1/√3)/2 и r, достаточно близкое к −1. Тогда производная отрицательна. Такое r достигается конечным выходом MLP, поэтому увеличить универсальный порог нельзя. Утверждение доказано.
Так как dp/dl = 1 − s − g > 0, при фиксированных признаках и параметрах эмиссии возрастает также зависимость q от базовой оценки владения навыком l. Это свойство не означает возрастания q с номером попытки: ошибки, новые задания и изменение контекста могут уменьшать прогноз.
Утверждение 2. Для любого бинарного ответа y и любого ρ ≥ 0 справедливы оценки:
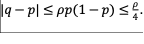
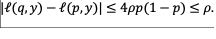
Здесь ℓ(q, y) = −y ln q − (1 − y) ln(1 − q). Доказательство первой оценки следует из σ′(x) = σ(x)(1 − σ(x)) ≤ 1/4 и теоремы Лагранжа: сдвиг аргумента сигмоиды не превосходит 4ρp(1 − p). Для второй оценки заметим, что производная бинарной логарифмической потери по логиту η равна σ(η) − y и по модулю не превосходит единицы. Повторное применение теоремы Лагранжа завершает доказательство.
Оценки (9)–(10) ограничивают размер вмешательства для каждого наблюдения, независимо от распределения данных и качества обучения MLP. Они допускают как улучшение, так и ухудшение прогноза. В частности, из них не следуют уменьшение средней ошибки, устойчивость к произвольному сдвигу распределения или педагогическая полезность решения о завершении обучения.
Обучение и вычислительная сложность
Сначала параметры BKT оцениваются на обучающих последовательностях, затем фиксируются. Для MLP минимизируется регуляризованная бинарная логарифмическая потеря:
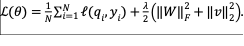
Такое разделение позволяет анализировать нейросетевое преобразование относительно фиксированного базового прогноза. Градиент по параметрам сети дополнительно умножается на ρw(p)(1 − tanh²fθ). Поэтому при крайних p и насыщении tanh обучение поправки замедляется. Это объясняет возможное недообучение контекстного эффекта даже при достаточной выразительности скрытого слоя.
Для d входных признаков и h скрытых нейронов MLP содержит h(d + 2) + 1 параметров. При d = 4 и h = 16 их 97; ещё четыре параметра принадлежат BKT. Один прогноз требует O(hd) операций, а состояние BKT для одного навыка хранится в одном числе. При нескольких навыках можно поддерживать отдельные состояния, но перенос результатов настоящего однонавыкового эксперимента на взаимодействующие навыки требует проверки.
План вычислительного эксперимента
Эксперимент является синтетическим: записи реальных обучающихся не использовались. Для каждого режима и каждого seed ∈ {11, 22, 33, 44, 55} сгенерированы 1000 независимых последовательностей длины 30. Первые 600 обучающихся включены в обучение, следующие 200 — в валидацию, последние 200 — в тест. Таким образом, одно разбиение содержит 18 000, 6000 и 6000 ответов соответственно. Разбиение по обучающимся исключает попадание частей одной последовательности в разные подвыборки. Всего сгенерировано 300 000 ответов в десяти наборах.
В обоих режимах истинное начальное владение навыком имеет вероятность 0,25, вероятность обучения равна 0,12, забывание отсутствует. Перед каждым ответом независимо генерируются признак задания dₜ ∼ U(−1, 1) и бинарный признак формата cₜ ∼ Bernoulli(0,5). Нелинейный контекстный эффект задаётся выражением:
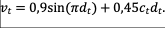
В контрольном режиме вместо (12) используется vₜ = 0. Вероятность правильного ответа при известном скрытом состоянии Kₜ = k вычисляется так:
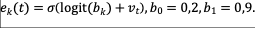
После генерации ответа выполняется переход обучения. Условие e₁(t) > e₀(t) сохраняется при любом контексте. Генератор изменяет эмиссии скрытой марковской модели и не совпадает с архитектурой (6). Тем не менее он специально содержит нелинейный доступный контекст, поэтому результаты характеризуют данный механизм, а не произвольные образовательные данные. Точный фильтр с известными параметрами генератора включён как ориентир достижимой ошибки, недоступный обучаемым моделям.
Вектор признаков MLP состоит из dₜ, cₜ, (t − 1)/29 и сглаженной доли предыдущих правильных ответов (1 + Sₜ₋₁)/(t + 1), где Sₜ₋₁ — число правильных ответов до попытки t. Последняя компонента равна 1/2 перед первой попыткой. Текущий ответ yₜ и последующие ответы в признаки не входят. Для каждой тестовой последовательности фильтрация начинается заново с обученного L₀; предыдущие тестовые ответы используются только после выдачи соответствующего прогноза.
BKT обучается алгоритмом ожидания–максимизации с тремя начальными наборами (L₀, T, g, s): (0,2; 0,1; 0,2; 0,1), (0,5; 0,2; 0,1; 0,2) и (0,1; 0,05; 0,3; 0,05). Выполняется до 100 итераций; остановка — при максимальном изменении параметров менее 10⁻⁶. Параметры L₀ и T ограничены интервалом [0,001; 0,999], g и s — [0,001; 0,49]. Выбирается запуск с наименьшей обучающей потерей. Ограничения исключают численную вырожденность и обеспечивают g + s < 1.
Все нейросетевые варианты используют 16 скрытых нейронов с tanh. Обучение выполняется Adam [6] с шагом 0,003, β₁ = 0,9, β₂ = 0,999 и ε = 10⁻⁸; размер мини-пакета 1024, число эпох 100. Для матриц и выходного вектора λ = 10⁻⁴, смещения не штрафуются. После каждой эпохи вычисляется валидационная NLL, для теста сохраняются веса лучшей эпохи. Амплитуда ρ = 0,8 задана одинаково для ограниченных моделей и не подбирается по тесту. Реализация использует Python 3.12 и NumPy 2.3.5; исходный код, прогнозы и значения метрик включены в материалы воспроизведения.
Сравниваемые модели и метрики
Сравниваются BKT; автономный MLP, получающий logit(pₜ) и четыре контекстных признака; линейная поправка logit(pₜ) + βᵀzₜ + b; неограниченная поправка logit(pₜ) + fθ(zₜ); ограниченная поправка без весового множителя logit(pₜ) + ρ tanh(fθ(zₜ)); предложенная модель (6). Автономный MLP имеет 113 параметров, нейросетевые поправки — по 97, линейная — пять. Обозначение MLP здесь не относится к рекуррентной DKT. Подбор архитектуры под реальные датасеты и сравнение с OptimNN или BKTransformer в эксперимент не входят.
Основные метрики — средняя логарифмическая потеря NLL и бинарная оценка Брайера BS [3]. Меньшие значения лучше:
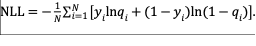
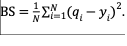
Для ECE интервал [0, 1] разделён на десять равных интервалов Iᵦ по прогнозу. Непустая группа характеризуется средним прогнозом q̄ᵦ и средней долей правильных ответов ȳᵦ:
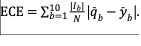
Пустые интервалы дают нулевой вклад. В таблице 1 приведены среднее и выборочное стандартное отклонение по пяти независимо сгенерированным наборам. Эти отклонения не являются доверительными интервалами. Дополнительно для каждого набора выполнен парный кластерный бутстрэп: 200 тестовых обучающихся выбираются с возвращением 2000 раз, сохраняя целиком все 30 ответов каждого выбранного обучающегося. Это учитывает зависимость ответов внутри последовательности.
Результаты и их интерпретация
В контекстном режиме предложенная модель уменьшила среднюю NLL на 0,0166, или примерно на 3,6%, и BS на 0,0049, или примерно на 3,4%, относительно BKT. Однако наименьшие значения среди обучаемых моделей получены для неограниченной поправки. Автономный MLP также оказался точнее предложенной конструкции по этим двум метрикам. Численные результаты представлены в таблице 1 и на рисунке 2.
Таблица 1.
Тестовые метрики при наличии контекстного эффекта
|
Модель |
NLL |
BS |
ECE |
|
BKT |
0,4594 ± 0,0054 |
0,1456 ± 0,0021 |
0,0093 ± 0,0042 |
|
Автономный MLP |
0,4359 ± 0,0072 |
0,1389 ± 0,0026 |
0,0140 ± 0,0021 |
|
Линейная поправка |
0,4429 ± 0,0055 |
0,1410 ± 0,0020 |
0,0243 ± 0,0039 |
|
Без ограничения |
0,4353 ± 0,0067 |
0,1387 ± 0,0024 |
0,0147 ± 0,0030 |
|
Без весов w(p) |
0,4392 ± 0,0055 |
0,1400 ± 0,0020 |
0,0193 ± 0,0033 |
|
Предложенная |
0,4428 ± 0,0057 |
0,1407 ± 0,0022 |
0,0298 ± 0,0040 |
|
Точный фильтр |
0,4320 ± 0,0064 |
0,1375 ± 0,0022 |
0,0088 ± 0,0018 |
Примечание. Среднее ± стандартное отклонение по пяти наборам; точный фильтр использует параметры генератора и не является обучаемым конкурентом.
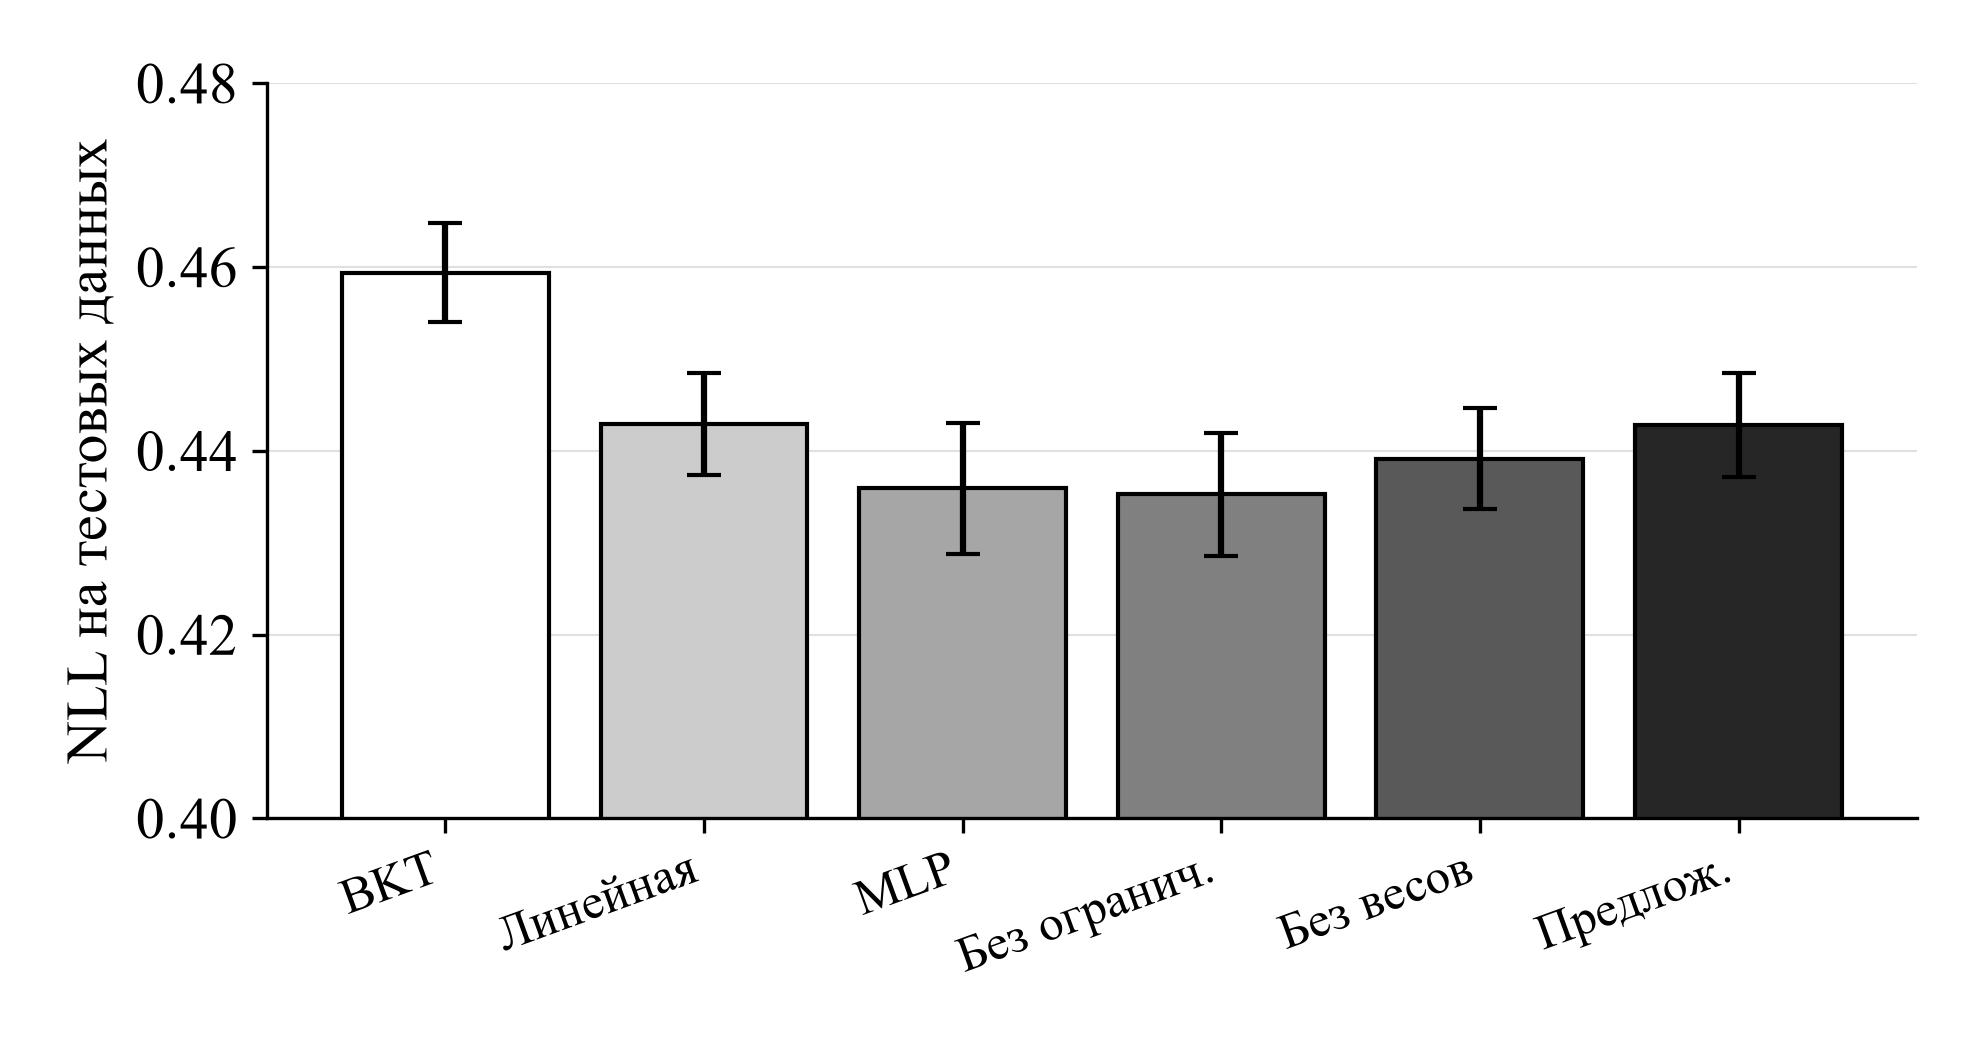
Рисунок 2. NLL в контекстном режиме и стандартное отклонение по пяти наборам
По ECE улучшения нет: значение выросло с 0,0093 у BKT до 0,0298 у предложенной модели. Низкая агрегированная ECE базовой модели совместима с худшими NLL и BS: группировка только по прогнозу может скрывать ошибки, различающиеся по контексту. Кроме того, нелинейная коррекция меняет состав интервалов. Поэтому приведённые результаты не позволяют называть модель откалиброванной, а проверка калибровки по подгруппам и отдельная валидационная калибровка остаются задачами дальнейшего исследования.
Для всех пяти контекстных наборов интервалы парной разности NLL между предложенной моделью и BKT лежат ниже нуля (таблица 2). Это свидетельство улучшения на тестовых обучающихся при фиксированных обученных моделях и заданном генераторе. Бутстрэп не включает повторное обучение и не отражает неопределённость выбора семейства генераторов; вывод о реальных образовательных платформах из этих интервалов не следует.
Таблица 2.
Парная разность NLL предложенной модели и BKT
|
Seed |
Разность NLL |
95% интервал бутстрэпа |
|
11 |
-0,0153 |
[-0,0199; -0,0104] |
|
22 |
-0,0194 |
[-0,0241; -0,0147] |
|
33 |
-0,0165 |
[-0,0210; -0,0121] |
|
44 |
-0,0157 |
[-0,0207; -0,0109] |
|
55 |
-0,0162 |
[-0,0212; -0,0113] |
В контрольном режиме без контекстного эффекта средняя NLL равна 0,422763 у BKT и 0,422765 у предложенной модели; BS составляет 0,131223 и 0,131220 соответственно. Во всех пяти запусках парный 95% интервал разности NLL включает ноль. Следовательно, этот режим не подтверждает полезность добавления MLP. ECE составляет 0,007599 и 0,008244: улучшение калибровки также отсутствует.
Максимальное наблюдавшееся изменение |q − p| для предложенной модели в контекстном режиме не превысило 0,1936, что согласуется с теоретической границей ρ/4 = 0,2. На сетке из 10 001 значения p и 101 значения r дополнительно проверены возрастание преобразования и локальная оценка (9). Эти численные проверки иллюстрируют доказанные свойства, но не заменяют доказательства. При p = 0,1 оценка (9) разрешает изменение не более 0,072, при p = 0,5 — не более 0,2.
Сопоставление упрощений объясняет цену ограничений. Неограниченная поправка даёт NLL 0,4353; ограничение tanh без весов увеличивает её до 0,4392; добавление w(p) — до 0,4428. В данном генераторе контекст влияет и на крайние прогнозы, поэтому ослабление поправки ограничивает полезную адаптацию. Линейная поправка с NLL 0,4429 почти совпадает с предложенной моделью по точности. Таким образом, эксперимент не доказывает преимущества сложности MLP при выбранной амплитуде; основанием для использования конструкции служат её явные ограничения и аналитические свойства.
Ограничения и дальнейшая проверка
Первое ограничение связано с данными: исследован один синтетический навык, фиксированная длина последовательности и независимый от ответов выбор контекста. Не рассмотрены пропуски, адаптивная выдача заданий, зависимость навыков и забывание. Второе ограничение — поэтапное обучение: MLP получает прогнозы BKT на тех же обучающих ответах, по которым оценены параметры фильтра. При переносе на малые реальные выборки следует сравнить этот вариант с перекрёстным формированием обучающих прогнозов.
Третье ограничение — локальный смысл монотонности: она доказана по p при фиксированном z, но не для произвольного изменения всей истории обучения. Четвёртое — отсутствие гарантии полезной коррекции. Если BKT уверенно ошибается, вес w(p) затрудняет исправление. Наконец, пять наборов и ограниченный набор гиперпараметров не позволяют оценить устойчивость вывода ко всем вариантам обучения. Параметр ρ следует выбирать на валидации в соответствии с допустимым вмешательством и ошибкой, сохраняя условие монотонности.
Следующий этап предполагает проверку на открытых учебных журналах с разбиением по обучающимся, одинаковым временным протоколом и анализом контекстных подгрупп. Для решения о прекращении практики потребуется отдельно оценить соответствие скрытого состояния владению навыком и последствия педагогического решения. Точность прогноза ответа сама по себе такую пригодность не устанавливает.
Заключение
Построена модель MLP и BKT с ограниченной контекстной поправкой в пространстве логарифма шансов. Для веса 4p(1 − p) выведен точный порог универсальной монотонности ρ* = 3√3/2 и получены оценки изменения вероятности и индивидуальной логарифмической потери. Эти результаты позволяют заранее задать предел вмешательства MLP в прогноз BKT.
На синтетических данных с контекстным эффектом предложенная модель улучшила NLL и BS относительно BKT, но уступила неограниченной нейросетевой поправке и увеличила ECE. Без контекстного эффекта преимущество не выявлено. Следовательно, доказанные ограничения следует рассматривать как управляемый компромисс, а не как гарантию максимальной точности или калибровки. Практическая ценность конструкции требует проверки на реальных образовательных последовательностях.
Список литературы
- Badrinath, A. Optimizing Bayesian Knowledge Tracing with Neural Network Parameter Generation / A. Badrinath, Z. Pardos // Journal of Educational Data Mining. — 2025. — Vol. 17, № 1. — P. 1–25. — DOI: 10.5281/zenodo.14707987
- Baker, R. S. J. d. More Accurate Student Modeling through Contextual Estimation of Slip and Guess Probabilities in Bayesian Knowledge Tracing / R. S. J. d. Baker, A. T. Corbett, V. Aleven // Intelligent Tutoring Systems. — Berlin ; Heidelberg : Springer, 2008. — P. 406–415. — (Lecture Notes in Computer Science ; vol. 5091). — DOI: 10.1007/978-3-540-69132-7_44
- Brier, G. W. Verification of Forecasts Expressed in Terms of Probability / G. W. Brier // Monthly Weather Review. — 1950. — Vol. 78, № 1. — P. 1–3. — DOI: 10.1175/1520-0493(1950)078<0001:VOFEIT>2.0.CO;2
- Corbett, A. T. Knowledge Tracing: Modeling the Acquisition of Procedural Knowledge / A. T. Corbett, J. R. Anderson // User Modeling and User-Adapted Interaction. — 1995. — Vol. 4. — P. 253–278. — DOI: 10.1007/BF01099821
- Guo, C. On Calibration of Modern Neural Networks / C. Guo, G. Pleiss, Y. Sun, K. Q. Weinberger // Proceedings of the 34th International Conference on Machine Learning. — 2017. — Vol. 70. — P. 1321–1330. — URL: https://proceedings.mlr.press/v70/guo17a.html (дата обращения: 23.10.2026)
- Kingma, D. P. Adam: A Method for Stochastic Optimization / D. P. Kingma, J. Ba // International Conference on Learning Representations. — 2015. — URL: https://arxiv.org/abs/1412.6980 (дата обращения: 23.10.2026)
- Piech, C. Deep Knowledge Tracing / C. Piech, J. Bassen, J. Huang [et al.] // Advances in Neural Information Processing Systems. — 2015. — Vol. 28. — P. 505–513. — URL: https://proceedings.neurips.cc/paper/2015/hash/bac9162b47c56fc8a4d2a519803d51b3-Abstract.html (дата обращения: 23.10.2026)
- Yudelson, M. V. Individualized Bayesian Knowledge Tracing Models / M. V. Yudelson, K. R. Koedinger, G. J. Gordon // Artificial Intelligence in Education. — Berlin ; Heidelberg : Springer, 2013. — P. 171–180. — (Lecture Notes in Computer Science ; vol. 7926). — DOI: 10.1007/978-3-642-39112-5_18