Введение
При обработке пользовательского запроса интеллектуальный ассистент определяет намерение, от которого зависит дальнейшее действие: установка будильника, поиск информации, изменение настроек устройства или управление календарём. Самого названия выбранного класса недостаточно, если система должна решать, выполнять ли действие без уточнения. Для такого решения необходима оценка неопределённости, связанная с действительной частотой ошибок.
Если среди решений с вероятностью около 0,8 правильными оказываются примерно 80%, вероятности можно считать калиброванными в этой области. Нейросетевая модель может достигать высокой точности, но при этом систематически завышать или занижать уверенность. Поэтому точность и калибровку следует измерять отдельно. Температурное преобразование вероятностей является одним из распространённых методов последующей калибровки [2].
Jev представляет интерес для такой оценки благодаря формату ответа. Примитив Choice возвращает выбранный вариант и вероятности всех заданных вариантов; отдельное поле confidence в документации характеризует концентрацию распределения и не тождественно вероятности правильности ответа [5]. Разработчик позиционирует Jev как модель для структурированных решений внутри программных систем. При этом качество её вероятностей на русскоязычных запросах требует самостоятельной проверки: согласно документации, основным языком обучения был английский [4].
Цель исследования — оценить точность и калибровку вероятностных решений Jev при классификации русскоязычных запросов к интеллектуальному ассистенту, а также проверить эффект температурной калибровки. Исследовательский вклад состоит в сопоставлении нескольких характеристик вероятностного ответа в этой задаче и выявлении условий, при которых они приводят к разным выводам.
Материалы и методы
Материалом служила русскоязычная часть корпуса MASSIVE, разработанного для оценки понимания запросов к виртуальному ассистенту. Полный корпус включает 60 намерений из 18 предметных областей [1]. В исследовании рассматривается задача определения одного намерения по тексту запроса.
Экспериментальный протокол содержал все 60 названий намерений и их русскоязычные пояснения. Для каждой записи в запрос Jev передавались текст высказывания и вопрос типа Choice. Из валидационной и тестовой частей выбиралось не более двух примеров для каждого класса. Выборка составлялась с фиксированным значением генератора случайных чисел; текстовые повторы между частями исключались. В итоге получено 118 валидационных и 117 тестовых запросов. В отдельных классах число доступных примеров оказалось меньше двух, что ограничивает анализ по классам.
Использовалась модель Jev 1.14, зафиксированная в ответах API как typesafe/jev-1.14-20261014. Для каждого запроса сохранялись истинная метка, выбранный моделью класс и вероятности всех классов. Поскольку в ответе API вероятности округлялись, перед вычислением метрик распределение нормировалось до суммы, равной единице. Параметр калибровки определялся только по валидационной части; результаты на тестовой части не применялись для его подбора.
Качество классификации оценивалось долей правильных ответов. Калибровка оценивалась ожидаемой ошибкой калибровки (ECE) по 10 интервалам максимальной вероятности, многоклассовой оценкой Брайера и отрицательным логарифмическим правдоподобием (NLL). ECE сопоставляет среднюю уверенность с долей правильных ответов внутри интервала. Оценка Брайера учитывает всё распределение по классам. NLL особенно чувствительно к случаям, когда правильному классу присвоена вероятность, близкая к нулю.
Для преобразования вероятностей применялось температурное масштабирование. Для исходного распределения p по классам преобразованная вероятность класса k вычислялась по формуле:
p̃ₖ(T) = pₖ^(1/T) / Σⱼ pⱼ^(1/T),
где T — положительный параметр температуры. Значение T = 3,765 подобрано минимизацией NLL на валидационной части. Преобразование сохраняет порядок вероятностей классов, поэтому не меняет точность классификации. Для вычисления логарифма нулевые вероятности в программной реализации ограничивались снизу значением 10⁻¹².
Дополнительно оценивалась селективная классификация: запросы упорядочивались по убыванию максимальной вероятности, после чего для каждой доли принятых запросов вычислялась доля ошибок среди них. Охват определялся как отношение числа принятых запросов к общему числу тестовых примеров. Показатель AURC в реализации рассчитывался как среднее значение риска по всем последовательным уровням охвата; меньшая величина соответствует меньшей средней ошибке при таком отборе. При одинаковой уверенности сохранялся исходный порядок записей.
Результаты
На тестовой части Jev верно определила намерение в 103 из 117 запросов. Значения оценочных показателей до и после температурного преобразования приведены в таблице 1.
Таблица 1.
Показатели классификации и калибровки на тестовой части
|
Показатель |
Исходные вероятности |
После калибровки |
|
Число запросов |
117 |
117 |
|
Точность |
0,880 |
0,880 |
|
ECE, 10 интервалов |
0,057 |
0,148 |
|
Многоклассовая оценка Брайера |
0,214 |
0,257 |
|
NLL |
1,280 |
0,714 |
Температурное преобразование снизило NLL с 1,280 до 0,714. При этом ECE возросла с 0,057 до 0,148, а многоклассовая оценка Брайера — с 0,214 до 0,257. Следовательно, по итогам данного прогона дополнительная калибровка не улучшила вероятностные решения по всем выбранным критериям. Неизменность точности ожидаема, поскольку температура не переставляет классы местами.
Парная бутстреп-оценка для изменения ECE после калибровки дала 95-процентный интервал от −0,003 до 0,147, включающий ноль. Поэтому величину ухудшения ECE следует трактовать осторожно. Для точности исходной модели 95-процентный бутстреп-интервал составил приблизительно от 0,821 до 0,932. Эти интервалы отражают неопределённость пилотной выборки, а не гарантируют такое же качество в реальной эксплуатации.
Особенно существенно поведение NLL. В четырёх тестовых примерах исходный ответ содержал нулевую вероятность правильного класса. При подстановке нижней границы 10⁻¹² каждый такой пример даёт большой вклад в логарифмическую потерю. Температурное преобразование перераспределяет вероятностную массу и резко уменьшает эту потерю, однако одновременно делает большинство уверенных ответов менее уверенными. Изменение нижней границы или точности выдаваемых вероятностей может изменить численное значение NLL. По этой причине улучшение одной логарифмической метрики не следует отождествлять с общим улучшением калибровки.
На рисунке 1 сопоставлены средняя максимальная вероятность класса и фактическая доля верных ответов в непустых интервалах вероятности. Пунктирная диагональ соответствует идеальной калибровке. Точки выше неё указывают на занижение уверенности, ниже — на её завышение.
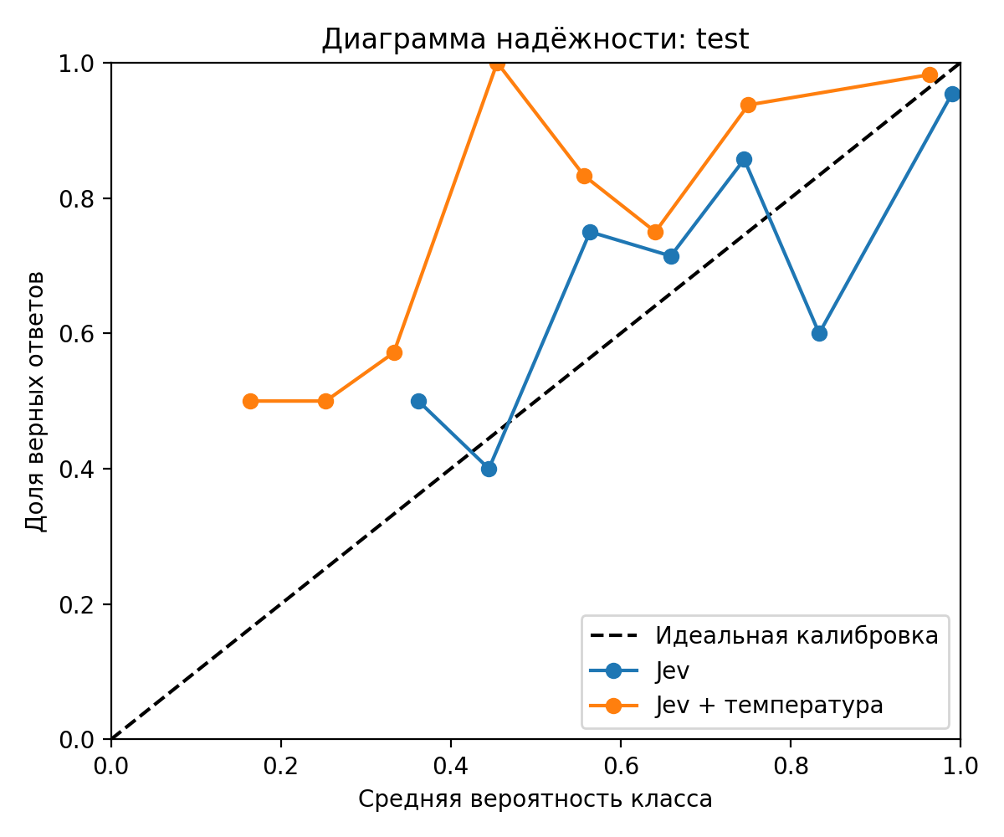
Рисунок 1. Диаграмма надёжности Jev до и после температурной калибровки
После температурного преобразования все представленные точки лежат выше диагонали: модель в среднем занижает уверенность внутри этих интервалов. Например, при средней вероятности около 0,455 все восемь ответов оказались правильными. Это согласуется с ростом ECE с 0,057 до 0,148. В исходном верхнем интервале средняя вероятность составила 0,990, а точность — 0,954 по 87 запросам, что указывает на некоторое завышение уверенности. Вывод о форме кривых остаётся предварительным: часть интервалов содержит лишь несколько наблюдений, а соединяющие линии служат визуальным ориентиром.
Рисунок 2 показывает долю ошибок среди запросов, принятых для автоматической обработки при последовательном снижении порога уверенности. Чем ниже кривая при одинаковом охвате, тем меньше ошибок в принятой части выборки. Остальные запросы предполагается направлять на уточнение или проверку.
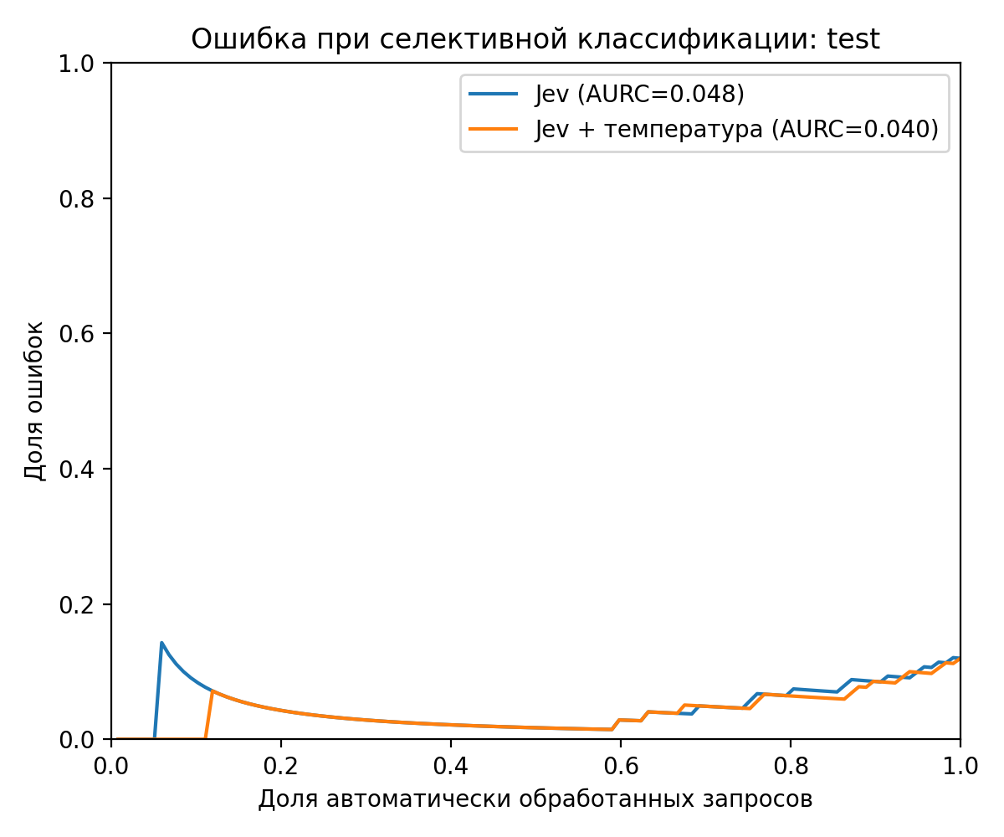
Рисунок 2. Доля ошибок в зависимости от охвата тестовых запросов
После преобразования AURC снизилась с 0,0482 до 0,0405: ранжирование запросов для выборочной обработки стало несколько лучше по этой метрике. При полном охвате обе кривые сходятся к доле ошибок 14/117, то есть около 12,0 %. Температура сохраняет выбранный класс каждого запроса, но может менять порядок уверенности между запросами. Поэтому снижение AURC совместимо с ростом ECE. Это наблюдение не устанавливает преимущество для рабочего порога: доверительный интервал AURC не оценивался, а начало кривой чувствительно к малому числу принятых примеров и порядку записей с одинаковой уверенностью.
Стоимость применения
По опубликованному тарифу TypeSafe стоимость Jev 1.14 составляет 0,042 доллара США за миллион входных токенов. Плата взимается за входные токены; стоимость выходных токенов не включается в расчёт, поскольку они предоставляются бесплатно [4]. Структурированный ответ модели при этом существует и может учитываться технической статистикой API.
В пилотном эксперименте по 235 запросам учтено 632 729 входных токенов. Применение к этому объёму прямого тарифа TypeSafe даёт условную оценку 0,0266 доллара США. Это расчётная величина по официальному тарифу разработчика, а не документально подтверждённая сумма списания за проведённый эксперимент. Стоимость одного запроса также зависит от длины описаний классов и способа группировки вопросов.
Для масштаба сравнения стандартный опубликованный тариф крупной модели GPT-5.6 Sol составляет 4 доллара за миллион входных и 20 долларов за миллион выходных токенов [3]. Таким образом, входной тариф Jev приблизительно в 95 раз ниже. Такое сопоставление характеризует цену единицы входа; оно не доказывает аналогичную разницу в стоимости правильно классифицированного запроса. Для вывода об экономической эффективности необходим прямой эксперимент с одинаковыми примерами, сопоставимыми инструкциями и учётом итогового качества.
Обсуждение и ограничения
Пилотный результат демонстрирует возможность применять Jev как специализированную модель выбора намерения с доступным распределением вероятностей. Это важно для систем, которые по порогу вероятности направляют запрос на автоматическое исполнение, дополнительное уточнение или проверку человеком. В то же время отдельное поле confidence в ответе Jev отражает форму распределения; для утверждений о калибровке в данной работе использовалась максимальная вероятность выбранного класса [5].
Выборка невелика и сформирована с ограничением по числу запросов каждого намерения. Такое выравнивание классов отличается от реальных частот запросов в конкретном ассистенте. Кроме того, описания классов написаны на русском языке и могут влиять на результат. Поэтому измеренные значения точности и калибровки относятся к этому протоколу, модели и выборке, а не ко всем русскоязычным сценариям. Опубликованная документация также указывает, что английский является основным языком обучения Jev [4].
Следующий этап исследования должен включать более крупную выборку, анализ ошибок по намерениям, проверку устойчивости к перефразированию и прямое сравнение с одной или несколькими крупными языковыми моделями. Для прикладного решения целесообразно дополнительно измерять качество при разных порогах автоматического исполнения и стоимость одного верного решения. Это позволит проверить, сохраняется ли ценовое преимущество специализированной модели при требуемом уровне надёжности.
Заключение
На 117 тестовых русскоязычных запросах к интеллектуальному ассистенту точность классификации Jev составила 88,0%, а ECE исходных вероятностей — 0,057. Последующая температурная калибровка уменьшила NLL, но увеличила ECE и оценку Брайера. Расхождение связано в том числе с чувствительностью логарифмической потери к нулевым вероятностям правильного класса. Диаграмма надёжности показывает занижение уверенности после преобразования, тогда как кривая риска и охвата выявляет небольшое снижение AURC с 0,0482 до 0,0405. Таким образом, соответствие вероятностей частоте правильных ответов и качество отбора запросов требуют раздельной оценки. Низкий входной тариф Jev и отсутствие отдельной платы за выходные токены делают модель интересной для массовой обработки структурированных запросов. Её преимущество по стоимости при сопоставимом качестве должно быть проверено в отдельном сравнительном эксперименте.
Список литературы
- FitzGerald J., Hench C., Peris C. и др. MASSIVE: A 1M-Example Multilingual Natural Language Understanding Dataset with 51 Typologically-Diverse Languages // arXiv. 2022. arXiv:2204.08582. URL: https://arxiv.org/abs/2204.08582 (дата обращения: 19.10.2026)
- Guo C., Pleiss G., Sun Y., Weinberger K. Q. On Calibration of Modern Neural Networks // Proceedings of the 34th International Conference on Machine Learning. 2017. Vol. 70. P. 1321–1330. URL: https://proceedings.mlr.press/v70/guo17a.html (дата обращения: 19.10.2026)
- OpenAI. Pricing // OpenAI API Documentation. URL: https://developers.openai.com/api/docs/pricing (дата обращения: 19.10.2026)
- TypeSafe AI. Models // TypeSafe Documentation. URL: https://docs.typesafe.ai/models (дата обращения: 19.10.2026)
- TypeSafe AI. Primitives (Questions) // TypeSafe Documentation. URL: https://docs.typesafe.ai/primitives (дата обращения: 19.10.2026)