Обработка персональных данных подразумевает соблюдение двух условий одновременно: минимизацию риска повторной идентификации и сохранение статистической ценности информации. Актуальность проблемы для России и стран СНГ подтверждается мониторингом 2025 года. По отчёту компании F6, число публичных утечек сократилось вдвое — до 250 случаев, однако совокупный объём скомпрометированных данных вырос до 767 млн строк, что в 1,5 раза больше, чем годом ранее [3]. Простого удаления прямых идентификаторов при этом недостаточно: личность восстанавливается по совокупности квазиидентификаторов [1]. Цель работы — сравнить существующие методы анонимизации и обосновать переход к гибридным схемам обработки.
Существующие методы анонимизации персональных данных можно разделить на четыре класса в зависимости от принципа преобразования данных и характера потерь полезности. Сравнительный анализ этих методов представлен в таблице 1.
Таблица 1.
Сравнительная характеристика методов анонимизации
|
Метод |
Принцип действия |
Ограничения |
Влияние на полезность данных |
|
Псевдонимизация |
Замена идентификаторов токенами |
Обратимость при наличии ключа |
Структура данных сохраняется при сохранении ключа соответствия |
|
k-анонимность |
Обобщение квазиидентификаторов до k неразличимых записей |
Атака на однородность группы |
Снижение детализации исходных данных |
|
Дифференциальная приватность |
Добавление шума в результаты запросов |
Критическая погрешность на малых выборках |
Появление статистической погрешности |
|
Синтетические данные |
Генерация искусственного набора данных по распределению исходного |
Затруднена верификация сохранения многомерных зависимостей и редких событий |
Снижение детализации исходных данных |
Из таблицы 1 видно, что повышение уровня приватности достигается ценой ухудшения одного из параметров качества данных.
На нижнем уровне защиты находится псевдонимизация. Данный метод предполагает замену прямых идентификаторов на уникальные токены-заменители [1]. При наличии ключа соответствия личность восстанавливается полностью. Кроме того, как показано в работе Бесова [1], злоумышленник способен связать псевдоним с реальным субъектом через сопоставление квазиидентификаторов с внешними открытыми базами данных. Следовательно, псевдонимизация сама по себе не обеспечивает необратимого обезличивания данных, поскольку при наличии дополнительной информации возможно восстановление личности субъекта.
Более строгие гарантии обеспечивает k-анонимность. Данный метод требует, чтобы каждый набор квазиидентификаторов встречался в выборке не менее k раз [1]. На практике это достигается путём обобщения значений квазиидентификаторов либо подавления отдельных значений или записей. Однако k-анонимность не контролирует распределение конфиденциальных атрибутов внутри сформированных групп, что порождает уязвимость к атакам на однородность. Для устранения данного недостатка были разработаны модели l-разнообразия и t-близости.
Модель l-разнообразия требует, чтобы в каждом классе эквивалентности, т. е. в группе записей с одинаковым набором обобщённых квазиидентификаторов конфиденциальный атрибут принимал не менее l различных значений. Таким образом, для класса эквивалентности C с множеством записей R(C) и функцией sens(r), возвращающей значение конфиденциального атрибута для записи r, условие l-разнообразия выполняется, если |{
Данная модель предотвращает атаки на однородность, однако не учитывает семантическую близость значений атрибута. Например, если конфиденциальный атрибут принимает значения «рак легких», «пневмония» и «грипп», формальное требование l=3 выполняется, но чувствительная информация об онкологическом диагнозе остается раскрытой.
Более строгой является модель t-близости, которая контролирует не только количество различных значений, но и расстояние между распределением конфиденциального атрибута внутри группы и его распределением во всем наборе данных [6]. Пусть P — распределение конфиденциального атрибута в классе эквивалентности C, а Q — его распределение во всей выборке D. Тогда условие t-близости выполняется, если
Дифференциальная приватность рассматривается как подход, предоставляющий строгие математические гарантии конфиденциальности данных [2]. Данный метод добавляет в результаты статистических запросов контролируемый шум, параметризованный уровнем e. Механизм добавления шума Лапласа описывается выражением:
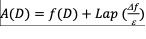
где
A(D) — анонимизированный ответ на запрос;
f(D) — истинное значение функции на наборе данных;
Δf — чувствительность функции;
Lap (b) — распределение Лапласа с масштабом b.
Чем меньше e, тем выше уровень приватности, но тем больше дисперсия добавляемого шума. Экспериментальные данные показывают, что при малых выборках снижение параметра e сопровождается ростом статистической погрешности оценок, что отмечается в ряде исследований.
Отдельного рассмотрения заслуживает генерация синтетических данных. На основе исходной выборки создаётся новый искусственный набор данных, который сохраняет статистические свойства, но не содержит реальных записей [1]. Основные методы генерации — вариационные автоэнкодеры (VAE) и генеративно-состязательные сети (GAN). Принцип работы VAE состоит в минимизации нижней границы вариационной оценки доказательства (ELBO) [5]:
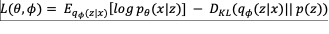
где
GAN, в свою очередь, строят состязательный процесс между генератором G и дискриминатором D. Генератор G стремится минимизировать эту функцию, а дискриминатор D — максимизировать. В идеале D(x) должно быть близко к 1 для реальных данных, а D(G(z)) — к 0 для сгенерированных. Таким образом, обучение сводится к минимаксной игре, в которой генератор пытается обмануть дискриминатор, а тот старается его разоблачить [4].
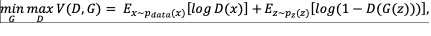
где
Генерация синтетических данных рассматривается как один из способов снижения риска раскрытия персональных данных без использования реальных записей. Вместе с тем применение генеративных моделей связано с рядом ограничений. Обучение таких моделей требует значительных вычислительных ресурсов, а качество синтетического набора напрямую зависит от полноты и структуры исходной выборки. Кроме того, редкие события могут воспроизводиться недостаточно точно, поскольку представлены в обучающих данных ограниченным количеством примеров. Это затрудняет использование синтетических данных в задачах, где важно сохранить аномальные или редко встречающиеся закономерности. По этой причине синтетический набор данных может сохранять основные статистические характеристики исходной выборки, но не полностью воспроизводить многомерные зависимости, имеющие значение для задач предиктивного моделирования.
Выполненное сравнение методов обезличивания персональных данных показывает, что рассмотренные методы обеспечивают различные компромиссы между уровнем приватности и сохранением полезности данных. Псевдонимизация обеспечивает минимальное изменение структуры данных, однако не исключает повторную идентификацию. Модели k-анонимности, l-разнообразия и t-близости снижают риск раскрытия конфиденциальной информации, но сопровождаются потерей детализации. Дифференциальная приватность предоставляет строгие математические гарантии защиты, однако ее применение требует выбора параметров, влияющих на точность результатов. Генерация синтетических данных открывает возможности безопасного обмена данными, но требует дополнительной оценки качества воспроизводимых статистических зависимостей. Поскольку каждый из рассмотренных методов обладает собственными преимуществами и ограничениями, перспективным представляется разработка адаптивных гибридных методов обезличивания.
Список литературы
- Бесов В.В., Данилова Д.В., Мекуриа Э.З. Методы обезличивания пользовательских данных: анализ применимости в условиях современных требований к приватности // Телекоммуникации и информационные технологии. — 2025. — Т. 12. — № 1. — С. 84–89
- Dwork C., Roth A. The Algorithmic Foundations of Differential Privacy // Foundations and Trends in Theoretical Computer Science. — 2014. — Vol. 9. — № 3–4. — P. 211–407
- F6. Киберугрозы-2025: F6 назвала основные тренды вымогателей, утечек, фишинга [Электронный ресурс]. — URL: https://www.f6.ru/media-center/press-releases/cyberthreats-2025/ (дата обращения: 17.03.2026)
- Goodfellow I., Pouget-Abadie J., Mirza M., Xu B., Warde-Farley D., Ozair S., Courville A., Bengio Y. Generative Adversarial Nets // Advances in Neural Information Processing Systems. — 2014. — Vol. 27. — P. 2672–2680
- Kingma D.P., Welling M. Auto-Encoding Variational Bayes // Proceedings of the 2nd International Conference on Learning Representations (ICLR). — Banff, Canada, 2014
- Li N., Li T., Venkatasubramanian S. t-Closeness: Privacy Beyond k-Anonymity and l-Diversity // Proceedings of the 23rd International Conference on Data Engineering (ICDE 2007). — Istanbul, Turkey, 2007. — P. 106–115
- Machanavajjhala A., Kifer D., Gehrke J., Venkatasubramanian M. l-Diversity: Privacy Beyond k-Anonymity // ACM Transactions on Knowledge Discovery from Data. — 2007. — Vol. 1. — № 1. — Article 3