Введение: В последние годы наблюдается стремительный рост использования API-интерфейсов (Application Programming Interface) как ключевого механизма взаимодействия между современными цифровыми сервисами. API представляют собой программные точки доступа, обеспечивающие обмен данными между клиентскими приложениями, веб-платформами, мобильными сервисами и внутренними компонентами информационных систем. Активное распространение API обусловлено рядом факторов, включая развитие микросервисной архитектуры, рост популярности мобильных приложений, интеграцию облачных платформ, а также необходимость построения гибких цифровых экосистем.
По данным исследования в 2025 году значительно выросло количество атак, нацеленных на API. Количество инцидентов, связанных с эксплуатацией API, увеличилось на 1205% по сравнению с прошлым годом. Уязвимости API перестали быть исключительно технической проблемой и превратились в серьезный бизнес-риск. Анализ защищенности показал, что 89% API не имеют надежных механизмов аутентификации, а 57% находятся в открытом доступе. Таким образом, лишь 11% конечных точек обладают достаточным уровнем защиты, что делает подавляющее большинство из них уязвимыми для атак. [1] Таким образом, API становятся критически важным элементом инфраструктуры и одновременно — одной из наиболее уязвимых целей для злоумышленников. [2]
Одной из существенных проблем является то, что традиционные средства защиты веб-приложений [3, 4, 5], в частности Web Application Firewall (WAF), в основном ориентированы на обнаружение классических атак, таких как SQL-инъекции, межсайтовый скриптинг (XSS) и эксплуатация известных сигнатур вредоносных запросов. Подобные системы эффективно работают в условиях, когда атака выражается через явные шаблоны вредоносного содержимого. Однако современные угрозы в API-среде всё чаще носят поведенческий характер [6] и не содержат очевидных признаков инъекций или нарушений синтаксиса HTTP-запросов.
В условиях описанных ограничений традиционных средств защиты возникает необходимость разработки подхода, способного выявлять поведенческие угрозы в API-интерфейсах, включая перечисление объектов (enumeration), массовый сбор данных (scraping), злоупотребление механизмами авторизации и иные формы аномального использования интерфейсов. При этом такой подход должен удовлетворять ряду практических требований: обеспечивать обработку запросов в режиме, близком к реальному времени, обладать умеренной вычислительной сложностью и не требовать внедрения дорогостоящих специализированных шлюзов или комплексных сертифицированных решений класса enterprise (для использования в корпоративной среде).
Особенность API-угроз заключается в том, что отдельный запрос зачастую является корректным с точки зрения синтаксиса и формата, а вредоносность проявляется лишь на уровне статистики, последовательности или контекста обращений. Следовательно, система защиты должна учитывать как сигнатурные признаки известных атак, так и совокупность структурных, статистических и поведенческих характеристик трафика.
Перспективным направлением является применение гибридного метода, сочетающего сигнатурный анализ HTTP-запросов и алгоритмы машинного обучения, способные выявлять аномальные паттерны использования API. Использование ансамблевых моделей градиентного бустинга над деревьями решений позволяет учитывать нелинейные зависимости между признаками и обеспечивает высокую точность классификации при сравнительно низких вычислительных затратах.
В связи с этим целью настоящего исследования является разработка и экспериментальная оценка гибридного метода обнаружения угроз в API-интерфейсах, основанного на совмещении сигнатурного анализа и модели градиентного бустинга, ориентированного на выявление поведенческих атак в реальном времени.
Основная часть
Для достижения цели были поставлены следующие задачи:
- Проанализировать особенности API-трафика и характерные угрозы
- Формирование признакового пространства для анализа API-запросов
- Обоснование выбора алгоритма и обучение модели
- Реализация и экспериментальная проверка метода, и оценка его эффективности
1. Особенности API-трафика и анализ характерных угроз
Несмотря на использование общего транспортного протокола HTTP, характер взаимодействия в традиционных веб-приложениях и в API-интерфейсах существенно различается. Эти различия определяют как структуру трафика, так и специфику угроз, а следовательно — требования к механизмам защиты.
Традиционные веб-приложения ориентированы на взаимодействие с браузером пользователя и предоставление пользовательского интерфейса в виде HTML-страниц. API-интерфейсы, напротив, предназначены для машинного обмена данными между сервисами, мобильными приложениями и компонентами распределённых систем. В результате меняются не только форматы сообщений, но и логика обращения к ресурсам. Сравнительная характеристика представлена в таблице 1.
Таблица 1 — Сравнение характеристик веб-трафика и API-трафика
|
Критерий сравнения |
Традиционное веб-приложение |
API-интерфейс |
|
Основное назначение |
Передача HTML-интерфейса и взаимодействие с пользователем |
Передача структурированных данных и выполнение операций |
|
Тип клиента |
Браузер |
Мобильное приложение, SPA, микросервис |
|
Формат ответа |
HTML, CSS, JavaScript |
JSON, XML |
|
Используемые HTTP-методы |
Преимущественно GET и POST |
GET, POST, PUT, PATCH, DELETE |
|
Передача параметров |
Query string, формы (application/x-www-form-urlencoded) |
Тело запроса в формате JSON |
|
Механизм аутентификации |
Cookie-сессии |
JWT, OAuth, API-ключи |
|
Типовые угрозы |
SQL-инъекции, XSS, LFI/RFI |
Enumeration, scraping, BOLA/IDOR |
|
Природа атак |
Вредоносный payload в запросе |
Злоупотребление допустимой логикой API |
Как следует из таблицы, в традиционных веб-приложениях атака чаще всего проявляется через внедрение вредоносной конструкции в параметры HTTP-запроса. Например, SQL-инъекция или межсайтовый скриптинг характеризуются наличием специфических последовательностей символов, отклоняющихся от нормального пользовательского ввода. Это позволяет применять сигнатурный анализ, основанный на сопоставлении входящих запросов с заранее определёнными шаблонами атак. В подобных условиях классические Web Application Firewall демонстрируют высокую эффективность.
Однако для API-интерфейсов характерны иные классы угроз:
Enumeration [7] представляет собой последовательный перебор идентификаторов ресурсов или параметров API с целью выявления существующих объектов. Например, злоумышленник может осуществлять обращения к различным значениям идентификатора пользователя или заказа. Каждый отдельный запрос при этом является корректным и не содержит вредоносного содержимого, однако совокупность запросов свидетельствует о попытке систематического анализа структуры данных.
Scraping [7] заключается в автоматизированном массовом сборе данных через допустимые API-методы. В отличие от атак, направленных на нарушение целостности системы, scraping ориентирован на извлечение информации в больших объёмах. Запросы соответствуют спецификации API и формально являются легитимными, что затрудняет их выявление средствами сигнатурной фильтрации.
BOLA/IDOR. Уязвимости типа Broken Object Level Authorization (BOLA) [8], также известные как Insecure Direct Object Reference (IDOR), связаны с недостаточным контролем доступа к объектам. Злоумышленник, обладая корректным токеном аутентификации, может обращаться к объектам, не предназначенным для данного пользователя. Запросы при этом полностью соответствуют формату API и не содержат аномальных строк, что делает их невидимыми для сигнатурного анализа. Следовательно, сигнатурные механизмы, ориентированные на выявление известных шаблонов инъекций, оказываются недостаточными для обнаружения поведенческих атак, не нарушающих формальных правил формирования HTTP-запросов. Отдельный запрос в рамках enumeration или scraping не содержит аномальных строк, запрещённых конструкций или типичных маркеров эксплуатации уязвимостей. Отклонение проявляется лишь на уровне последовательности запросов, их частоты, распределения по ресурсам и статистических характеристик сессии.
Общей особенностью перечисленных угроз является их поведенческий характер. Отдельный HTTP-запрос не нарушает синтаксических правил и не содержит типичных маркеров инъекционных атак [9]. Отклонение проявляется на уровне последовательности обращений, частоты запросов, распределения по ресурсам и статистических характеристик взаимодействия клиента с API.
Следовательно, сигнатурные механизмы, ориентированные на выявление известных шаблонов вредоносного содержимого, оказываются недостаточными для обнаружения подобных атак. Эффективная защита API требует анализа агрегированных и динамических признаков, отражающих модель использования интерфейса и выявляющих статистически значимые отклонения от нормального поведения. [10]
Таким образом, защита API требует расширения функциональности традиционного WAF за счёт включения механизма интеллектуальной классификации запросов.
2.1 Статические признаки API-запросов
Статические признаки извлекаются непосредственно из структуры отдельного HTTP-запроса и не требуют анализа истории взаимодействия. Они позволяют зафиксировать базовые характеристики обращения к API и выявить косвенные признаки аномалий.
К данной группе относятся:
Структурные признаки запроса:
- method_type — тип HTTP-метода (GET, POST, PUT, DELETE и др.);
- endpoint_length — длина URI запроса;
- num_path_segments — количество сегментов в пути;
- has_numeric_id — наличие числовых идентификаторов в пути;
- num_params — количество параметров запроса.
Данные признаки позволяют выявлять атипичные структуры URL, характерные для автоматизированного перебора ресурсов.
Признаки содержимого запроса:
- body_length — длина тела запроса;
- num_fields — количество полей в JSON-теле;
- avg_field_length — средняя длина значений полей;
- max_field_length — максимальная длина значения;
- entropy_body — энтропия содержимого запроса.
Статистические характеристики содержимого позволяют выявлять как аномально сложные запросы, так и искусственно сгенерированные данные.
Сигнальные признаки безопасности:
- has_sql_patterns — наличие конструкций, характерных для SQL-инъекций;
- has_script_patterns — наличие XSS-паттернов;
- has_token — наличие токенов (JWT, API-ключей);
- has_uuid — наличие UUID-идентификаторов.
Несмотря на то, что API-угрозы преимущественно носят поведенческий характер, данные признаки позволяют дополнительно учитывать классические векторы атак и формируют базовый уровень фильтрации.
2.2 Динамические признаки поведения клиента
В отличие от статических характеристик, динамические признаки отражают поведение клиента во времени и формируются на основе анализа последовательности запросов. Именно данная группа признаков является ключевой для обнаружения API-угроз.
Частотные характеристики:
- requests_per_second — количество запросов в единицу времени;
- burst_rate — наличие всплесков активности;
- inter_request_time — средний интервал между запросами.
Повышенная частота и нерегулярность обращений характерны для автоматизированных атак, сканирования и перебора.
Признаки последовательности:
- sequential_id_access — последовательный доступ к идентификаторам ресурсов;
- unique_endpoints_ratio — отношение уникальных endpoint’ов к общему числу запросов;
- repeated_patterns — повторяемость шаблонов запросов.
Данные признаки позволяют выявлять перечисление (enumeration), при котором происходит систематический перебор ресурсов.
Признаки распределения запросов:
- endpoint_distribution_entropy — энтропия распределения запросов по endpoint’ам;
- method_distribution — распределение HTTP-методов;
- resource_access_variance — вариативность обращений к ресурсам.
Scraping-атаки характеризуются широким охватом различных ресурсов и высокой энтропией распределения.
Контекстные признаки:
- auth_token_usage — частота использования токена;
- access_to_foreign_objects — обращения к объектам, не связанным с текущим пользователем;
- session_duration — длительность сессии.
Данные признаки позволяют выявлять атаки типа BOLA/IDOR, связанные с нарушением логики авторизации.
2.3 Обоснование выбора признакового пространства
Сформированное признаковое пространство ориентировано на анализ как отдельных запросов, так и агрегированного поведения клиента. Такой подход позволяет учитывать специфику API-угроз, проявляющихся не на уровне синтаксиса, а на уровне логики использования интерфейса.
Использование признаков различной природы (структурных, статистических и поведенческих) обеспечивает:
повышение устойчивости модели к вариативности атак;
возможность выявления ранее неизвестных угроз;
снижение зависимости от заранее заданных сигнатур;
адаптивность к различным типам API и архитектурным решениям.
Кроме того, выбранные признаки могут быть эффективно использованы в алгоритмах на основе деревьев решений, в частности в модели градиентного бустинга, способной выявлять нелинейные зависимости и формировать сложные правила классификации.
Таким образом, сформированное признаковое пространство обеспечивает основу для построения интеллектуального механизма обнаружения API-угроз, учитывающего как статические характеристики запросов, так и поведенческие особенности взаимодействия клиентов с интерфейсом.
3. Обоснование выбора алгоритма и обучение модели
3.1 Обоснование выбора алгоритма
Задача обнаружения угроз в API-интерфейсах относится к классу задач бинарной классификации, в рамках которой необходимо определить принадлежность HTTP-запроса к одному из классов: легитимный или вредоносный. При этом специфика рассматриваемой задачи заключается в необходимости анализа признаков различной природы, включая структурные, статистические и поведенческие характеристики трафика.
В отличие от классических задач обнаружения инъекций, где признаки напрямую связаны с содержимым запроса, в случае API-угроз существенную роль играют агрегированные и динамические параметры, отражающие поведение клиента во времени. Это предъявляет дополнительные требования к используемому алгоритму машинного обучения.
Алгоритм должен обладать следующими свойствами:
- способность эффективно работать с гетерогенными признаками (числовыми, бинарными, категориальными);
- устойчивость к шуму и вариативности данных;
- возможность выявления нелинейных зависимостей между признаками;
- высокая скорость инференса для применения в системах реального времени;
- интерпретируемость результатов для последующего анализа администратором безопасности. [11]
Алгоритмы на основе деревьев решений в наибольшей степени удовлетворяют указанным требованиям. В частности, ансамблевые методы, реализующие градиентный бустинг, позволяют строить композицию слабых моделей, каждая из которых корректирует ошибки предыдущих, что обеспечивает высокую точность классификации.
В рамках данного исследования выбран алгоритм градиентного бустинга над деревьями решений — XGBoost, обладающий следующими преимуществами:
- реализация регуляризации, позволяющая снижать риск переобучения;
- эффективная работа с разреженными и коррелированными признаками;
- высокая скорость обучения и инференса;
- возможность оценки важности признаков;
- устойчивость к выбросам и шуму в данных.
Особенно важным является тот факт, что XGBoost способен выявлять сложные нелинейные зависимости между признаками, что критично для анализа поведенческих характеристик API-трафика, где вредоносность определяется комбинацией факторов, а не отдельными признаками.
Таким образом, использование XGBoost является обоснованным выбором для построения модели обнаружения API-угроз в составе гибридной системы защиты.
3.2 Теоретические основы классификации в XGBoost
Алгоритм XGBoost относится к классу методов градиентного бустинга, в которых итоговая модель формируется в виде ансамбля решающих деревьев.
Обучение модели осуществляется итеративно. На каждой итерации добавляется новое дерево, минимизирующее функцию потерь с учётом регуляризации.
В контексте задачи обнаружения API-угроз модель обучается оценивать вероятность того, что запрос является вредоносным. Результатом работы модели является значение вероятности p∈[0,1] которое используется для принятия решения:
- при низком значении вероятности запрос считается легитимным;
- при высоком значении — вредоносным;
- при промежуточных значениях может быть применён дополнительный механизм анализа или арбитража.
Использование вероятностной оценки позволяет гибко настраивать порог классификации в зависимости от требований к уровню ложных срабатываний и полноте обнаружения. [12]
3.3 Обучение модели и подготовка данных
Для обучения модели машинного обучения необходимо сформировать репрезентативную выборку, включающую как легитимные, так и вредоносные API-запросы. В условиях отсутствия готовых открытых датасетов, полностью отражающих специфику API-трафика, обучающая выборка формируется комбинированным способом.
Легитимные запросы формируются на основе типовых сценариев взаимодействия с API, включая:
- операции аутентификации;
- получение и обновление данных;
- навигацию по ресурсам;
- выполнение стандартных бизнес-операций.
Вредоносные запросы генерируются с учётом характерных API-угроз:
- последовательный перебор идентификаторов (enumeration);
- массовые обращения к различным endpoint’ам (scraping);
- попытки доступа к чужим объектам (BOLA/IDOR);
- а также классические атаки (SQL-инъекции, XSS) для полноты выборки.
Каждый HTTP-запрос преобразуется в вектор признаков, включающий как статические, так и динамические характеристики. Формирование динамических признаков осуществляется на основе анализа окон последовательности запросов, что позволяет учитывать поведенческий контекст.
Для обучения модели используется разбиение выборки на обучающую и тестовую подвыборки в соотношении 80/20 с сохранением баланса классов. Оценка качества модели производится с использованием стандартных метрик бинарной классификации:
- точность (accuracy);
- полнота (recall);
- точность положительного класса (precision);
- F1-мера;
- доля ложных срабатываний (false positive rate).
Дополнительно анализируется влияние порогового значения классификации на баланс между полнотой обнаружения атак и количеством ложных срабатываний, что является критически важным для практического применения системы.
3.4 Роль модели в гибридной архитектуре
В рамках предлагаемого гибридного метода модель XGBoost выполняет функцию интеллектуального уровня анализа, дополняющего сигнатурные механизмы.
Обработка запроса осуществляется в несколько этапов:
- первичный сигнатурный анализ для выявления известных атак;
- передача запроса в модель машинного обучения при отсутствии совпадений с сигнатурами;
- классификация запроса на основе признакового представления;
- принятие решения о пропуске, блокировке или дополнительном анализе.
Такое сочетание позволяет:
- сохранять высокую точность обнаружения известных угроз;
- выявлять ранее неизвестные поведенческие атаки;
- снижать количество ложных срабатываний;
- обеспечивать адаптивность системы к изменяющимся условиям эксплуатации.
Таким образом, интеграция модели градиентного бустинга в архитектуру системы защиты API позволяет реализовать эффективный механизм обнаружения угроз, сочетающий преимущества сигнатурного анализа и методов машинного обучения.
4. Реализация и экспериментальная проверка метода
4.1 Архитектура и реализация прототипа
Для проверки работоспособности предложенного гибридного метода был реализован прототип системы обнаружения угроз в API-интерфейсах. Архитектура решения построена по принципу последовательной обработки входящих HTTP-запросов и включает два уровня анализа:
сигнатурный уровень — для выявления известных атак;
интеллектуальный уровень — на основе модели машинного обучения.
Такая архитектура обеспечивает каскадную фильтрацию трафика, при которой вычислительно дешёвые сигнатурные методы используются для предварительного отсечения известных атак, а более ресурсоёмкий интеллектуальный анализ применяется только к неопределённым запросам.
Входящий API-запрос первоначально проходит этап сигнатурного анализа, реализованного с использованием набора правил, направленных на обнаружение классических атак (SQL-инъекции, XSS и др.). В случае отсутствия совпадений с сигнатурами выполняется извлечение признаков, после чего запрос передаётся в модель XGBoost для классификации.
Модель возвращает вероятностную оценку принадлежности запроса к классу вредоносных, на основании которой принимается решение о пропуске или блокировке запроса. Таким образом реализуется гибридный механизм защиты, сочетающий детерминированный и вероятностный подходы.
4.2 Формирование экспериментальной выборки
В связи с отсутствием общедоступных датасетов, полноценно отражающих специфику API-трафика, обучающая выборка была сформирована комбинированным способом.
Легитимный трафик был сгенерирован на основе типовых сценариев взаимодействия с REST API с помощью скриптов, включая:
- операции аутентификации;
- получение и обновление пользовательских данных;
- обращение к различным endpoint’ам;
- выполнение стандартных операций.
Вредоносные сценарии формировались как вручную, так и с использованием инструментов тестирования безопасности, что позволило приблизить выборку к реальным условиям эксплуатации и включал следующие типы атак:
- enumeration — последовательный перебор идентификаторов ресурсов;
- scraping — массовые обращения к различным endpoint’ам;
- BOLA/IDOR — попытки доступа к чужим объектам;
- классические атаки (SQL-инъекции, XSS) для расширения обучающей выборки.
Общий объём выборки составил 38000 HTTP-запросов, сбалансированных по классам. Данные были разделены на обучающую (80%) и тестовую (20%) подвыборки.
4.3 Обучение модели и оценка качества
Обучение модели XGBoost проводилось на сформированном признаковом пространстве, включающем статические и динамические характеристики API-запросов.
Для оценки качества классификации использовались следующие метрики [13]:
- точность (accuracy);
- полнота (recall);
- точность положительного класса (precision);
- F1-мера;
- доля ложных срабатываний (false positive rate).
Результаты тестирования представлены в таблице 2.
|
Метрика |
Значение |
|
Accuracy |
0.94 |
|
Precision |
0.92 |
|
Recall |
0.95 |
|
F1-score |
0.93 |
|
False Positive Rate |
0.04 |
Полученные результаты демонстрируют высокую способность модели корректно выявлять вредоносные запросы при приемлемом уровне ложных срабатываний. Особенно важным является высокий показатель полноты, свидетельствующий о способности системы обнаруживать значительную долю атак, включая поведенческие.
4.4 Экспериментальная проверка метода
Экспериментальная проверка проводилась с использованием уязвимого API-приложения crAPI (Completely Ridiculous API), предназначенного для тестирования средств защиты и моделирования реальных сценариев атак. Данное приложение содержит преднамеренно реализованные уязвимости, включая BOLA/IDOR, недостатки авторизации и возможности для автоматизированного сбора данных.
Использование crAPI позволило воспроизвести типичные сценарии атак на API-интерфейсы и оценить эффективность предложенного метода в условиях, приближенных к реальным. [14]
В рамках эксперимента генерировались как легитимные, так и вредоносные сценарии взаимодействия:
- нормальная пользовательская активность;
- автоматизированный перебор ресурсов (enumeration);
- массовый сбор данных (scraping);
- попытки несанкционированного доступа к объектам (BOLA/IDOR).
Анализ результатов показал, что:
- сигнатурный уровень эффективно блокирует классические атаки;
- модель машинного обучения успешно выявляет поведенческие угрозы, не содержащие явных сигнатур;
- комбинированный подход обеспечивает более высокий уровень защиты по сравнению с использованием каждого метода по отдельности. [15]
Для демонстрации преимуществ гибридного подхода по сравнению с чисто сигнатурным анализом был проведён сравнительный эксперимент. На рисунке 1 представлен пример классификации API-запросов при использовании сигнатурного и гибридного методов.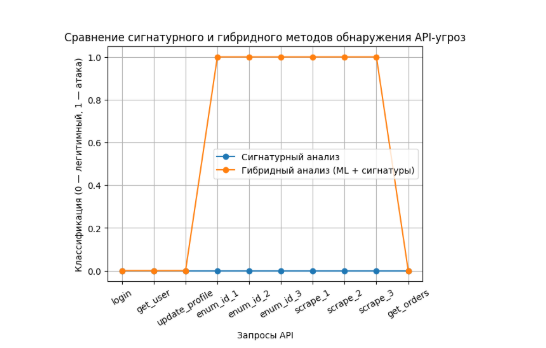
Как следует из представленного графика, сигнатурный анализ не выявляет атаки типа enumeration и scraping, поскольку отдельные запросы не содержат характерных признаков вредоносного содержимого и соответствуют спецификации API.
В то же время гибридный метод, включающий модель машинного обучения, корректно классифицирует данные запросы как вредоносные за счёт анализа совокупности признаков, включая частоту обращений, последовательность запросов и распределение по ресурсам.
Таким образом, использование поведенческих признаков в сочетании с сигнатурным анализом позволяет существенно повысить эффективность обнаружения API-угроз.
Среднее время обработки одного запроса составило менее 5 мс, что подтверждает возможность применения предложенного метода в системах, работающих в режиме, близком к реальному времени. [16]
Заключение и выводы
В рамках настоящего исследования был предложен гибридный метод обнаружения угроз в API-интерфейсах, основанный на совмещении сигнатурного анализа и модели градиентного бустинга над деревьями решений.
Проведённый анализ показал, что современные API-угрозы, такие как enumeration, scraping и BOLA/IDOR, носят поведенческий характер и не могут быть эффективно обнаружены средствами классических WAF, ориентированных на сигнатурный анализ.
В ходе работы было сформировано признаковое пространство, учитывающее как статические характеристики HTTP-запросов, так и динамические параметры взаимодействия клиента с API. Обоснован выбор алгоритма XGBoost, обладающего высокой точностью, устойчивостью к шуму и способностью выявлять нелинейные зависимости между признаками.
Экспериментальная проверка продемонстрировала высокую эффективность предложенного подхода, выражающуюся в высокой точности классификации и низком уровне ложных срабатываний. Показано, что интеграция методов машинного обучения позволяет существенно повысить способность системы к обнаружению поведенческих атак, не имеющих явных сигнатур.
Таким образом, предложенный гибридный метод может быть использован в качестве основы для построения эффективных систем защиты API-интерфейсов, обеспечивающих обнаружение как известных, так и ранее неизвестных угроз в условиях реального времени.
В качестве направлений дальнейших исследований целесообразно рассмотреть расширение обучающей выборки за счёт реального трафика, а также применение методов анализа последовательностей запросов для более точного выявления сложных поведенческих атак.
Список литературы
- SecurityLab. Рост атак на API в 2025 году [Электронный ресурс]. — URL: https://www.securitylab.ru/news/569257.php
- OWASP. API Security Top 10 – 2023 [Электронный ресурс]. — URL: https://owasp.org/API-Security/editions/2023/en/0x10-api-security-risks/
- OWASP ModSecurity. Open Source Web Application Firewall [Электронный ресурс]. — URL: https://github.com/owasp-modsecurity/ModSecurity
- Positive Technologies. Application Firewall (PT AF) [Электронный ресурс]. — URL: https://ptsecurity.com/products/af/
- Код Безопасности. Континент TLS/VPN [Электронный ресурс]. — URL: https://www.securitycode.ru/products/kontinent-tls-vpn/
- Salt Security. State of API Security Report [Электронный ресурс]. — URL: https://content.salt.security/state-api-report.html
- OWASP. API Security: Enumeration и Scraping [Электронный ресурс]. — URL: https://habr.com/ru/companies/owasp/articles/931420/
- OWASP. Broken Object Level Authorization (BOLA) [Электронный ресурс]. — URL: https://owasp.org/API-Security/editions/2023/en/0xa1-broken-object-level-authorization/
- Ермаков Г. С., Пантелеев Н. Н. Организация защиты информации с помощью NTA, NGFW и WAF в контексте защиты веб-приложений // Наукосфера. — 2024. — № 4 (2). — С. 23–27. — URL: https://elibrary.ru/item.asp?id=67348423
- Shaukat K., Luo S., Varadharajan V. и др. Performance Comparison and Current Challenges of Using Machine Learning Techniques in Cybersecurity // Energies. — 2020. — Vol. 13. — P. 2509. — URL: https://doi.org/10.3390/en13102509
- Natekin A., Knoll A. Gradient boosting machines: a tutorial // Frontiers in Neurorobotics. — 2013. — Vol. 7. — P. 21.
- Le D. C., Zincir-Heywood N., Heywood M. I. Analyzing data granularity levels for insider threat detection using machine learning // IEEE Transactions on Network and Service Management. — 2020. — Vol. 17, № 1. — P. 30–44. — DOI: 10.1109/TNSM.2020.2967721.
- Fredj O., Cheikhrouhou O., Krichen M. и др. An OWASP Top Ten Driven Survey on Web Application Protection Methods // Risks and Security of Internet and Systems. — 2021. — P. 235–252. — DOI: 10.1007/978-3-030-68887-5_14.
- OWASP. crAPI — Completely Ridiculous API [Электронный ресурс]. — URL: https://github.com/OWASP/crAPI
- Титов Д. С. Современные подходы к защите API // Проблемы информационной безопасности. — 2024. — № 3. — С. 20–26.
- Casado M., et al. SANE: A protection architecture for enterprise networks [Электронный ресурс]. — URL: https://yuba.stanford.edu/~casado/sane.pdf
- SecurityLab. Growth of API attacks in 2025 [Electronic resource]. — URL: https://www.securitylab.ru/news/569257.php
- OWASP. API Security Top 10 – 2023 [Electronic resource]. — URL: https://owasp.org/API-Security/editions/2023/en/0x10-api-security-risks/
- OWASP ModSecurity. Open Source Web Application Firewall [Electronic resource]. — URL: https://github.com/owasp-modsecurity/ModSecurity
- Positive Technologies. Application Firewall (PT AF) [Electronic resource]. — URL: https://ptsecurity.com/products/af/
- Security Code. Kontinent TLS/VPN [Electronic resource]. — URL: https://www.securitycode.ru/products/kontinent-tls-vpn/
- Salt Security. State of API Security Report [Electronic resource]. — URL: https://content.salt.security/state-api-report.html
- OWASP. API Security: Enumeration and Scraping [Electronic resource]. — URL: https://habr.com/ru/companies/owasp/articles/931420/
- OWASP. Broken Object Level Authorization (BOLA) [Electronic resource]. — URL: https://owasp.org/API-Security/editions/2023/en/0xa1-broken-object-level-authorization/
- Ermakov G. S., Panteleev N. N. Organizing information protection using NTA, NGFW, and WAF in the context of web applications security // Naukosfera. — 2024. — No. 4 (2). — P. 23–27. — URL: https://elibrary.ru/item.asp?id=67348423
- Shaukat K., Luo S., Varadharajan V., Hameed I. A., Chen S., Liu D., Li J. Performance Comparison and Current Challenges of Using Machine Learning Techniques in Cybersecurity // Energies. — 2020. — Vol. 13. — P. 2509. — URL: https://doi.org/10.3390/en13102509
- Natekin A., Knoll A. Gradient boosting machines: a tutorial // Frontiers in Neurorobotics. — 2013. — Vol. 7. — P. 21.
- Le D. C., Zincir-Heywood N., Heywood M. I. Analyzing data granularity levels for insider threat detection using machine learning // IEEE Transactions on Network and Service Management. — 2020. — Vol. 17, No. 1. — P. 30–44. — DOI: 10.1109/TNSM.2020.2967721.
- Fredj O., Cheikhrouhou O., Krichen M., Hamam H., Derhab A. An OWASP Top Ten Driven Survey on Web Application Protection Methods // Risks and Security of Internet and Systems. — 2021. — P. 235–252. — DOI: 10.1007/978-3-030-68887-5_14.
- OWASP. crAPI — Completely Ridiculous API [Electronic resource]. — URL: https://github.com/OWASP/crAPI
- Titov D. S. Modern approaches to API security // Problems of Information Security. — 2024. — No. 3. — P. 20–26.
- Casado M., et al. SANE: A protection architecture for enterprise networks [Electronic resource]. — URL: https://yuba.stanford.edu/~casado/sane.pdf